AGIBOT laat X2 antwoorden met spraak en passende gebaren
XBot-Omni verbindt beelden en geluid met spreken, bewegen en aanwijzen. De onderzoekers tonen X2-demonstraties, geen gemeten betrouwbaarheid in dagelijks werk.
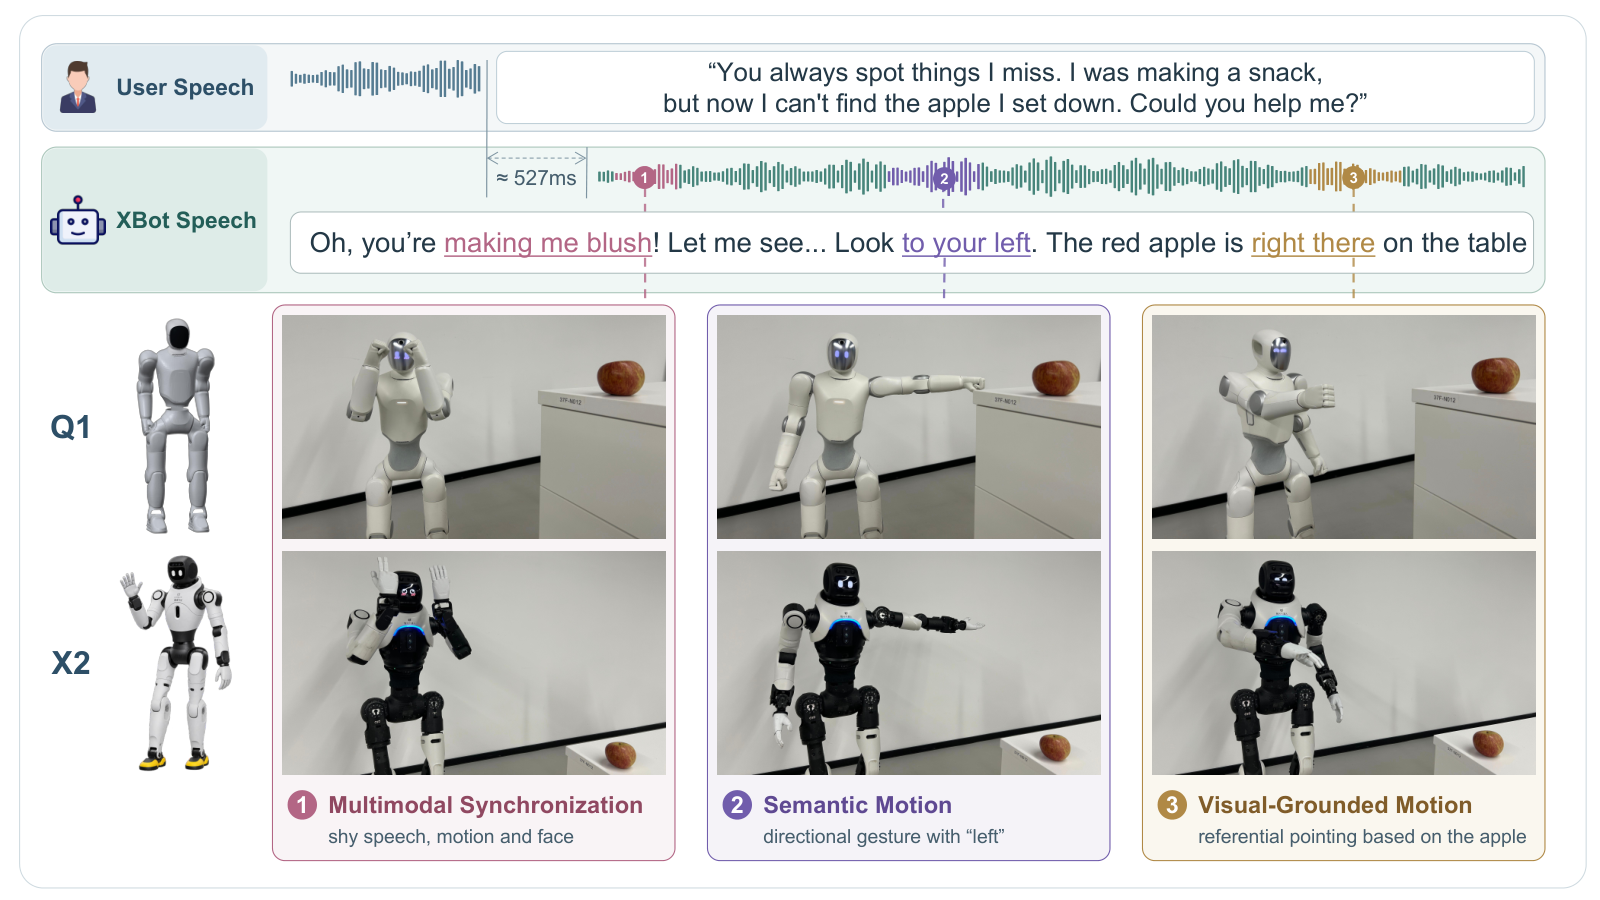
Kerui Gu en collega’s van AGIBOT X-Lab presenteren XBot-Omni in een preprint. Het model combineert beeld, geluid en taal met spraak en lichaamsbewegingen. In de getoonde demonstraties maakt een X2 gebaren bij zijn antwoord en wijst hij naar een voorwerp in beeld. De studie toont daarnaast een PrimeBOT Q1; de figuur laat beide robots afzonderlijk zien. De onderzoekers toetsen onder meer waarneming en het genereren van bewegingen met vaste gegevensverzamelingen. Die scores zijn geen slagingspercentage van fysieke klantgesprekken. De gebruikte rekenhardware voor de X2-demonstratie wordt niet gespecificeerd. Ook een beschikbaarheidsdatum voor deze software op verkoopbare X2-uitvoeringen ontbreekt.
Wat betekent dit?
Passende gebaren kunnen een uitleg begrijpelijker maken. Voor een receptie of rondleiding blijven vooral reactietijd, verstaanbaarheid en herstel bij misverstanden te toetsen.
Bron: Kerui Gu en medeonderzoekers bij AGIBOT X-Lab, XBot-Omni ↗. Samengevat door YourWally op basis van de publicatie van de onderzoekers.